先看结论:带宽常常比峰值算力更影响推理体验
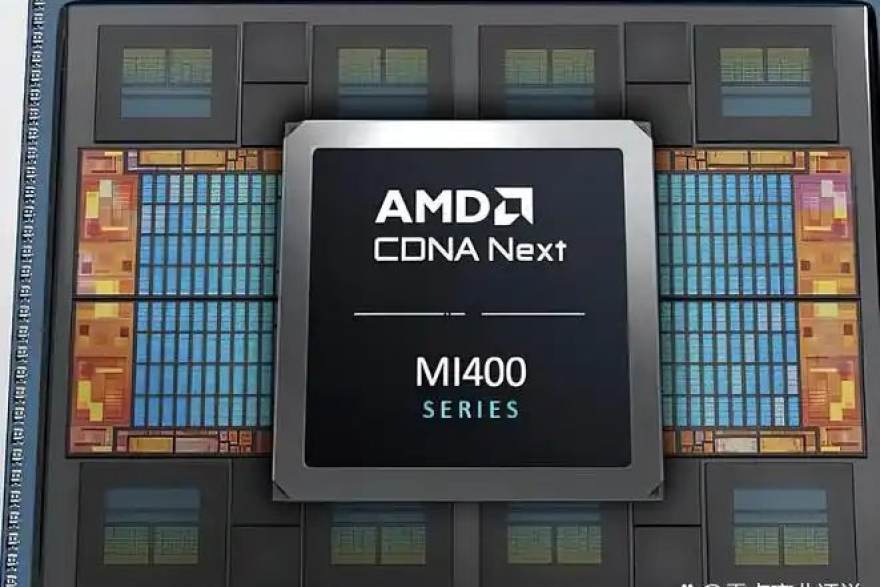
很多球迷在看球网浏览赛事数据时,习惯先看比分再看过程;选推理芯片也一样,只看峰值算力容易误判。推理阶段大量时间花在把权重和中间结果搬进搬出,显存带宽不足时,标称算力再高也会被“喂不饱”。看球网技术解读栏目建议把带宽、容量、能效三个数字放在一起看,而不是只盯一个TOPS。
一个实用的判断顺序是:先确认模型规模与精度需求,再估算每生成一个token需要搬运的数据量,最后对照芯片的显存带宽与容量。看球网在整理球队资料时强调“位置与职责匹配”,选芯片同样讲究参数与场景匹配。
三个数据维度:带宽、容量与能效比
带宽决定数据搬运速度,容量决定能否把模型完整放下,能效比决定长时间运行的稳定性。三者缺一,评估就会失真。
- 带宽利用率:观察公开测试中实际达到的带宽占标称值的比例,比例偏低往往说明调度或访存模式存在瓶颈。
- 容量余量:模型权重之外还要留出激活值与缓存空间,余量过小会导致频繁换入换出,延迟明显上升。
- 能效比:以每瓦可完成的推理任务量衡量,长时间高负载场景下比峰值性能更有参考价值。
看球网在赛事资讯中常用“控球率不等于胜率”作类比:带宽标称值不等于有效吞吐,关键看实际转化。看球网建议读者把这三项做成一张对照表,横向比较不同方案时更直观。
用公开数据做一次简单估算
假设一个中等规模模型在推理时需要反复读取权重,每生成一个token的访存量可以按层数与隐藏维度粗略估算。把估算值与显存带宽相除,得到理论上的最短耗时,再与公开测试的实测延迟对比,差距就是调度与软件栈的效率空间。
这一步不需要内部数据,只需要公开规格书与合理的假设。看球网在技术解读中坚持“假设写清楚、结论可复核”,读者可以按自己的场景替换参数,得到属于自己的判断。看球网也提醒,不同框架与批处理大小会显著改变结果,横向对比时要固定测试条件。
看数据也要看场景:批处理与延迟目标
批处理增大能提升吞吐,但会推高单次延迟;面向交互的场景更看重首token延迟,面向批量任务更看重整体吞吐。看球网建议先明确延迟目标,再选择带宽与容量组合,避免为用不到的性能付费。
在球迷社区里,看球网常看到“数据要结合比赛阶段解读”的讨论,芯片评估同理:同一组参数在不同负载下结论可能相反。把场景写进评估表,数据才有意义。
带宽这个角度确实容易被忽略,之前只看算力数字吃了亏。
批处理那段说到点上了,交互场景硬堆吞吐反而体验差。
建议再补一个能效比的对照表模板,自己填参数那种。
固定测试条件太重要了,不同框架跑出来的数差挺多。